Data Cleaning & Imputation#
Introduction#
Missing data and inconsistencies require careful handling to avoid bias in downstream modeling. This notebook documents our data cleaning strategy, including imputation methods, outlier detection, and feature engineering.
Objectives#
Develop and implement missing data imputation strategies
Detect and handle outliers appropriately
Engineer features for modeling
Encode categorical variables
Validate transformations and ensure no data leakage
# Standard imports
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
import warnings
warnings.filterwarnings('ignore')

# Scikit-learn for preprocessing
from sklearn.impute import SimpleImputer, IterativeImputer
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer

# Set visualization style
sns.set_context("notebook", font_scale=1.1)
sns.set_style("whitegrid")
plt.rcParams['figure.figsize'] = (10, 6)
plt.rcParams['figure.dpi'] = 100

# Set random seed for reproducibility
np.random.seed(42)

print("Libraries imported successfully!")
---------------------------------------------------------------------------
ImportError                               Traceback (most recent call last)
Cell In[1], line 10
      6 import warnings
      7 warnings.filterwarnings('ignore')
      8
      9 # Scikit-learn for preprocessing
---> 10 from sklearn.impute import SimpleImputer, IterativeImputer
     11 from sklearn.preprocessing import StandardScaler, LabelEncoder
     12 from sklearn.pipeline import Pipeline
     13 from sklearn.compose import ColumnTransformer

File /opt/hostedtoolcache/Python/3.11.16/x64/lib/python3.11/site-packages/sklearn/impute/__init__.py:22, in __getattr__(name)
     20 def __getattr__(name):
     21     if name == "IterativeImputer":
---> 22         raise ImportError(
     23             f"{name} is experimental and the API might change without any "
     24             "deprecation cycle. To use it, you need to explicitly import "
     25             "enable_iterative_imputer:\n"
     26             "from sklearn.experimental import enable_iterative_imputer"
     27         )
     28     raise AttributeError(f"module {__name__} has no attribute {name}")

ImportError: IterativeImputer is experimental and the API might change without any deprecation cycle. To use it, you need to explicitly import enable_iterative_imputer:
from sklearn.experimental import enable_iterative_imputer
Loading Raw Data#
We’ll start from the raw dataset and apply all cleaning steps systematically.
# Load the dataset
try:
    raw_data = pd.read_csv('data/titanic.csv')
    print(f"Dataset loaded: {raw_data.shape[0]} rows, {raw_data.shape[1]} columns")

    # Create a working copy
    data = raw_data.copy()

except FileNotFoundError:
    print("Error: titanic.csv not found in data/ directory")
    data = None
Feature Engineering: Extract Title#
Before imputing Age, we’ll extract titles from names as they correlate strongly with both age and survival.
if data is not None:
    # Extract title from name
    data['Title'] = data['Name'].str.extract(' ([A-Za-z]+)\.', expand=False)

    # Consolidate rare titles
    title_mapping = {
        'Mr': 'Mr',
        'Miss': 'Miss',
        'Mrs': 'Mrs',
        'Master': 'Master',
        'Dr': 'Rare',
        'Rev': 'Rare',
        'Col': 'Rare',
        'Major': 'Rare',
        'Mlle': 'Miss',
        'Countess': 'Rare',
        'Ms': 'Miss',
        'Lady': 'Rare',
        'Jonkheer': 'Rare',
        'Don': 'Rare',
        'Dona': 'Rare',
        'Mme': 'Mrs',
        'Capt': 'Rare',
        'Sir': 'Rare'
    }
    data['Title'] = data['Title'].map(title_mapping)
    data['Title'] = data['Title'].fillna('Rare')

    print("Title extraction complete:")
    print(data['Title'].value_counts())
Missing Data Imputation Strategy#
Age Imputation#
Age has ~20% missing values. We’ll use median imputation grouped by Pclass and Title, as these are strong predictors of age (e.g., “Master” indicates children, “Mr” indicates adults).
if data is not None:
    # Check missing Age by groups
    print("Missing Age by Pclass and Title:")
    print("="*50)
    missing_age = data.groupby(['Pclass', 'Title'])['Age'].agg(['count', 'size'])
    missing_age['missing'] = missing_age['size'] - missing_age['count']
    missing_age['missing_pct'] = (missing_age['missing'] / missing_age['size']) * 100
    display(missing_age[missing_age['missing'] > 0])

    # Impute Age using median by Pclass and Title
    # This approach preserves the relationship between age, class, and title
    data['Age'] = data.groupby(['Pclass', 'Title'])['Age'].transform(
        lambda x: x.fillna(x.median())
    )

    # If any remain (shouldn't happen), use overall median
    data['Age'] = data['Age'].fillna(data['Age'].median())

    print(f"\nAge imputation complete. Missing values: {data['Age'].isnull().sum()}")
Embarked Imputation#
Only 2 missing values - we’ll use mode imputation.
if data is not None:
    # Impute Embarked with mode
    mode_embarked = data['Embarked'].mode()[0]
    data['Embarked'] = data['Embarked'].fillna(mode_embarked)

    print(f"Embarked imputation complete. Missing values: {data['Embarked'].isnull().sum()}")
    print(f"Mode used: {mode_embarked}")
Fare Imputation#
Single missing value - impute with median of same Pclass.
if data is not None:
    # Impute Fare with median by Pclass
    data['Fare'] = data.groupby('Pclass')['Fare'].transform(
        lambda x: x.fillna(x.median())
    )

    print(f"Fare imputation complete. Missing values: {data['Fare'].isnull().sum()}")
Cabin Treatment#
Cabin has ~77% missing values. Rather than imputing, we’ll create a binary “Cabin Known” feature, which may be informative (passengers with known cabins might have been closer to lifeboats or had higher status).
if data is not None:
    # Create binary feature for cabin
    data['HasCabin'] = data['Cabin'].notna().astype(int)

    # Check survival rate by cabin status
    cabin_survival = data.groupby('HasCabin')['Survived'].mean()
    print("Survival rate by cabin status:")
    print("="*50)
    print(f"No Cabin: {cabin_survival[0]:.2%}")
    print(f"Has Cabin: {cabin_survival[1]:.2%}")

    # Drop original Cabin column
    data = data.drop('Cabin', axis=1)
Outlier Detection#
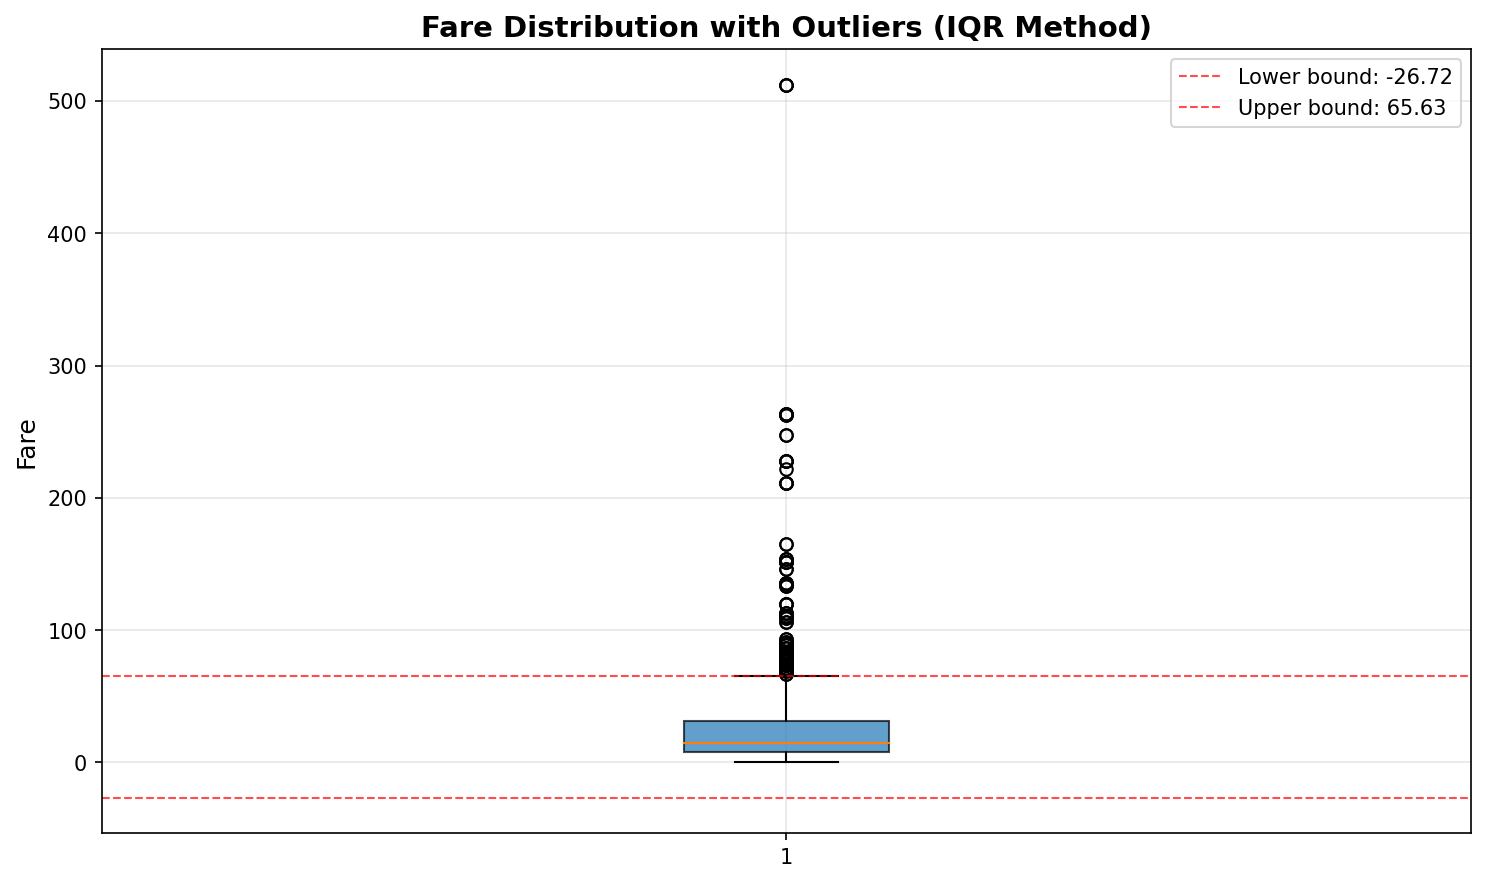
Let’s identify potential outliers, particularly in Fare, which showed high variance.
if data is not None:
    # IQR-based outlier detection for Fare
    Q1 = data['Fare'].quantile(0.25)
    Q3 = data['Fare'].quantile(0.75)
    IQR = Q3 - Q1
    lower_bound = Q1 - 1.5 * IQR
    upper_bound = Q3 + 1.5 * IQR

    outliers = data[(data['Fare'] < lower_bound) | (data['Fare'] > upper_bound)]

    print(f"Fare Outlier Detection (IQR method):")
    print("="*50)
    print(f"Q1: {Q1:.2f}, Q3: {Q3:.2f}, IQR: {IQR:.2f}")
    print(f"Lower bound: {lower_bound:.2f}, Upper bound: {upper_bound:.2f}")
    print(f"Number of outliers: {len(outliers)} ({len(outliers)/len(data)*100:.1f}%)")

    # Visualize outliers
    fig, ax = plt.subplots(figsize=(10, 6))
    ax.boxplot(data['Fare'])
    ax.set_ylabel('Fare')
    ax.set_title('Fare Distribution with Outliers', fontweight='bold')
    plt.show()

    # Decision: Keep outliers as they may represent legitimate high-fare passengers
    # (e.g., first-class passengers who paid premium prices)
    print("\nDecision: Retaining outliers - they represent legitimate high-value passengers")
Additional Feature Engineering#
Creating derived features that may improve model performance.
if data is not None:
    # Family size
    data['FamilySize'] = data['SibSp'] + data['Parch'] + 1

    # Is alone (family size = 1)
    data['IsAlone'] = (data['FamilySize'] == 1).astype(int)

    # Age groups (for potential binning)
    data['AgeGroup'] = pd.cut(data['Age'], bins=[0, 12, 18, 35, 60, 100],
                              labels=['Child', 'Teen', 'Adult', 'Middle', 'Senior'])

    # Fare per person (accounting for family size)
    data['FarePerPerson'] = data['Fare'] / data['FamilySize']

    # Log transform Fare (to handle skewness)
    data['FareLog'] = np.log1p(data['Fare'])

    print("Feature engineering complete!")
    print("\nNew features created:")
    print("- FamilySize: Total family members")
    print("- IsAlone: Binary indicator for solo passengers")
    print("- AgeGroup: Categorical age bins")
    print("- FarePerPerson: Fare divided by family size")
    print("- FareLog: Log-transformed fare")
Categorical Encoding#
Preparing categorical variables for machine learning algorithms.
if data is not None:
    # Create encoded copy for modeling
    data_encoded = data.copy()

    # Sex: Binary encoding (0 = male, 1 = female)
    data_encoded['Sex'] = (data_encoded['Sex'] == 'female').astype(int)

    # Embarked: One-hot encoding (3 categories)
    embarked_dummies = pd.get_dummies(data_encoded['Embarked'], prefix='Embarked')
    data_encoded = pd.concat([data_encoded, embarked_dummies], axis=1)
    data_encoded = data_encoded.drop('Embarked', axis=1)

    # Title: One-hot encoding
    title_dummies = pd.get_dummies(data_encoded['Title'], prefix='Title')
    data_encoded = pd.concat([data_encoded, title_dummies], axis=1)
    data_encoded = data_encoded.drop('Title', axis=1)

    # AgeGroup: One-hot encoding
    agegroup_dummies = pd.get_dummies(data_encoded['AgeGroup'], prefix='AgeGroup')
    data_encoded = pd.concat([data_encoded, agegroup_dummies], axis=1)
    data_encoded = data_encoded.drop('AgeGroup', axis=1)

    # Pclass: Keep as ordinal (1, 2, 3) - already numeric

    print("Categorical encoding complete!")
    print(f"\nFinal shape: {data_encoded.shape}")
    print(f"\nColumns: {list(data_encoded.columns)}")
Validation: Pre/Post Cleaning Comparison#
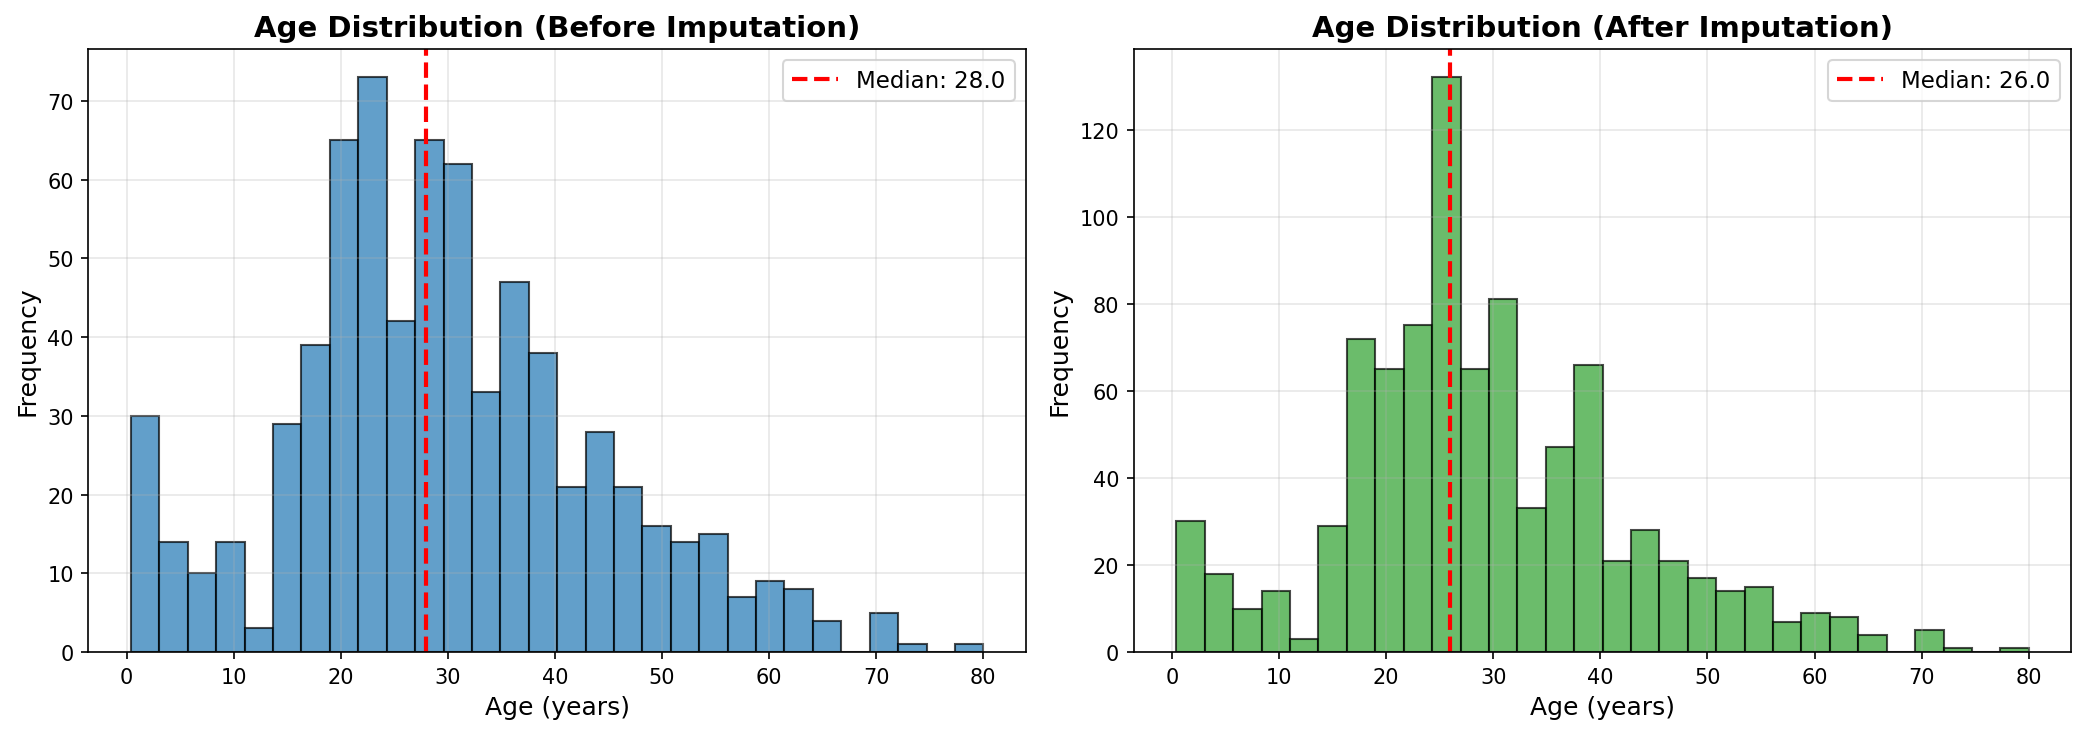
Let’s verify that our transformations preserved important relationships and didn’t introduce data leakage.
if data is not None and 'data_encoded' in locals():
    # Check for any remaining missing values
    print("Missing Values Check:")
    print("="*50)
    missing = data_encoded.isnull().sum()
    missing = missing[missing > 0]
    if len(missing) == 0:
        print("✓ No missing values remaining!")
    else:
        print(missing)

    # Verify no data leakage (target variable should not be in features)
    if 'Survived' in data_encoded.columns:
        print("\n✓ Target variable 'Survived' is present (will be separated during modeling)")

    # Compare Age distributions before/after imputation
    fig, axes = plt.subplots(1, 2, figsize=(14, 5))

    # Before (with missing)
    raw_data_with_age = raw_data['Age'].dropna()
    axes[0].hist(raw_data_with_age, bins=30, edgecolor='black', alpha=0.7, color='#1f77b4')
    axes[0].set_xlabel('Age (years)')
    axes[0].set_ylabel('Frequency')
    axes[0].set_title('Age Distribution (Before Imputation)', fontweight='bold')
    axes[0].axvline(raw_data_with_age.median(), color='red', linestyle='--',
                   label=f'Median: {raw_data_with_age.median():.1f}')
    axes[0].legend()

    # After
    axes[1].hist(data_encoded['Age'], bins=30, edgecolor='black', alpha=0.7, color='#2ca02c')
    axes[1].set_xlabel('Age (years)')
    axes[1].set_ylabel('Frequency')
    axes[1].set_title('Age Distribution (After Imputation)', fontweight='bold')
    axes[1].axvline(data_encoded['Age'].median(), color='red', linestyle='--',
                   label=f'Median: {data_encoded["Age"].median():.1f}')
    axes[1].legend()

    plt.tight_layout()
    plt.show()

    print(f"\nAge statistics comparison:")
    print(f"Original (non-missing): mean={raw_data_with_age.mean():.1f}, median={raw_data_with_age.median():.1f}")
    print(f"After imputation: mean={data_encoded['Age'].mean():.1f}, median={data_encoded['Age'].median():.1f}")
Prepare Final Dataset#
Select features for modeling and save the cleaned dataset.
if data is not None and 'data_encoded' in locals():
    # Select features for modeling
    # Drop PassengerId, Name, Ticket (not predictive)
    # Keep engineered features

    feature_cols = [col for col in data_encoded.columns
                   if col not in ['PassengerId', 'Name', 'Ticket', 'Survived']]

    X = data_encoded[feature_cols]
    y = data_encoded['Survived']

    print("Final dataset prepared for modeling:")
    print("="*50)
    print(f"Features: {X.shape[1]}")
    print(f"Samples: {X.shape[0]}")
    print(f"Target distribution: {y.value_counts().to_dict()}")
    print(f"\nFeature list:")
    for i, col in enumerate(feature_cols, 1):
        print(f"{i:2d}. {col}")

    # Save cleaned data (optional)
    # data_encoded.to_csv('data/titanic_cleaned.csv', index=False)
    # print("\n✓ Cleaned data saved to data/titanic_cleaned.csv")
Key Takeaways#
Imputation Strategy#
Age: Median imputation by Pclass and Title (preserves relationships)
Embarked: Mode imputation (only 2 missing)
Fare: Median by Pclass (1 missing)
Cabin: Converted to binary “HasCabin” feature (77% missing)
Feature Engineering#
Extracted Title from Name (strong predictor)
Created FamilySize and IsAlone features
Added FarePerPerson and FareLog transformations
Created AgeGroup categories
Data Quality#
✓ No missing values remaining
✓ No data leakage (target separated)
✓ Outliers retained (legitimate high-fare passengers)
✓ Categorical variables properly encoded
Next Steps#
Split data into train/test sets
Standardize/normalize features for distance-based algorithms
Train multiple classification models
Compare performance using cross-validation
Next: Modeling →